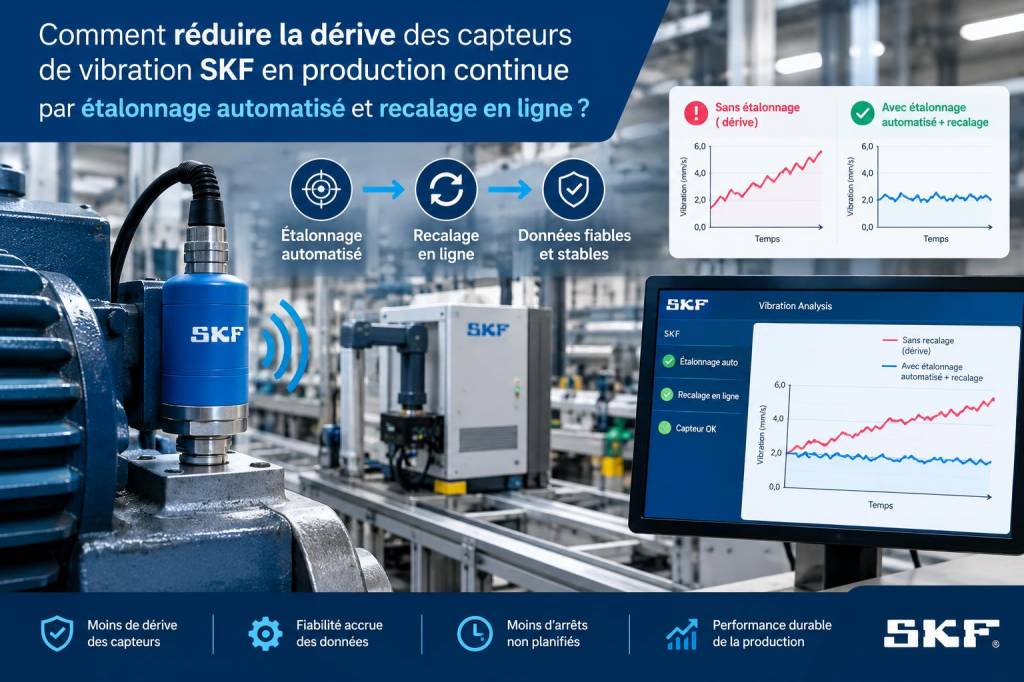
En production continue, la dérive des capteurs de vibration est l'une des causes silencieuses de diagnostics erronés et d'interventions inutiles. J'ai longuement travaillé sur ce sujet en production : capteurs SKF montés sur roulements, carters et paliers, déploiements massifs avec collecte continue, et retour d'expérience sur comment limiter la dérive grâce à un étalonnage automatisé et à des opérations de recalage en ligne.
Pourquoi la dérive des capteurs est un vrai problème en production continue
La dérive peut provenir de plusieurs sources : vieillissement des composants électroniques, variations thermiques, pollution/colmatage mécanique du capteur, erreurs d'assemblage ou de câblage, ou même variations de l'alimentation. En pratique, cela se traduit par :
fausses alarmes (bruit augmentant sans défaillance mécanique),manque de sensibilité (défaillance naissante non détectée),perte de confiance des opérateurs dans le système de maintenance prédictive.Un instrument qui dérive fausse l'historique et rend les modèles prédictifs inutilisables. D'où l'importance d'un plan d'étalonnage automatisé et de recalage en ligne qui s'insèrent dans la chaîne de supervision (SCADA / plateforme IoT).
Principes que j'applique systématiquement
Pour moi, réduire la dérive repose sur trois piliers complémentaires :
Prévention : sélectionner des capteurs robustes et protéger mécaniquement l'installation (caps, joints, conduits).Détection : surveiller les signatures de santé du capteur (impédance, bruit de fond, température) et non seulement les grandeurs mécaniques.Correction : corriger automatiquement l'étalonnage via des références internes ou externes et recalage en ligne sans arrêter la production.Architecture d'une solution d'étalonnage automatisé
Je privilégie une architecture hybride edge + cloud :
Edge : collecte des données brutes, filtrage temps réel, vérifications de cohérence et exécution des procédures de recalage immédiates (appliquer offsets, coefficients de gain).Cloud / plateforme IoT : corrélation historique, modèles de dérive, génération automatique de workflows d'étalonnage, tableau de bord et gestion des certificats d'étalonnage.Concrètement, sur Bioelec nous avons intégré des capteurs SKF (référence : SKF Microlog, ou capteurs industriels sans fil SKF) avec des gateways edge capables d'exécuter routines d'étalonnage. L'edge exécute une série de tests simples : test d'impédance, mesure de bruit à repos, injection d'une référence connue (voir plus bas).
Méthodes d'étalonnage et recalage en ligne
Voici les méthodes que j'ai testées et combinées :
Étalo en usine + traceabilité : conserver et exploiter le certificat d'étalonnage origine. Permet d'identifier une dérive importante rapidement.Référence mécanique locale (shaker de référence) : intégrer un petit exciteur électrodynamique (shaker) sur un point de référence de la machine ou sur une structure dédiée. À horaire programmé, on injecte une vibration de référence et le capteur ajuste offset/gain. Cette méthode est très fiable car elle calibre la chaîne mécanique + capteur.Référence électrique : injection d'un signal électrique connu sur l'étage d'entrée (si le capteur le permet) pour vérifier l'amplification et détecter dérive des composants électroniques.Comparaison croisée : montage d'un capteur de référence permanent (capteur étalonné et blindé) et comparaison continue. En cas d'écart systématique, l'algorithme applique un recalage ou génère une intervention.Compensation en température : mesurer la température locale du capteur et appliquer des polynômes de correction. Très utile quand la dérive suit un profil thermique.Auto-vérification périodique : routines de « self-test » embarquées (impédance, bruit à 0 g, mesure de courant d'alimentation).Algorithmes de détection de dérive
Je préconise une approche en couches :
Seuils de plausibilité : valeurs maxi/min pour chaque métrique (RMS, crest factor, fréquence dominante) selon l'historique.Détection de dérive lente : régression linéaire sur fenêtre mobile (30–90 jours) pour détecter tendance continue hors tolérance.Détection de dérive rapide : changement brusque détecté par CUSUM ou tests statistique (p.ex. test de Mann-Kendall) déclenche une procédure d'étalonnage immédiate.Validation multi-capteur : si un ensemble de capteurs montés sur la même machine montre des évolutions cohérentes mais l'un diffère, c'est souvent un problème capteur.Mise en œuvre pratique : un workflow type que j'utilise
Voici un exemple de workflow automatisé que j'ai mis en place sur une ligne 24/7 :
1) Collecte continue des vibrations et paramètres santé (temp, impédance).2) Calcul edge de la signature de référence et détection d'anomalie de capteur.3) En cas d'écart détecté, exécution automatique d'un test de recalage via shaker local (programme de 30s).4) Si recalage OK (gain/offset corrigés), tag automatique dans l'historique : « recalage automatique appliqué ».5) Si recalage échoue ou dépasse seuils, ouverture d'un ticket dans la GMAO et alerte opérateur (avec instructions : vérifier fixation, câble, remplacer capteur).Ce workflow garde l'usine en marche tout en garantissant la qualité des données.
Paramètres opérationnels et recommandations
| Paramètre | Valeur recommandée | Remarque |
| Fréquence d'étalonnage automatisé | Hebdomadaire à mensuel | Plus fréquent si production critique ou conditions variables |
| Fenêtre de détection dérive | 30–90 jours | Adapter selon historique de dérive |
| Seuil d'intervention automatique | ±3–5% gain ou offset | Dépend de la criticité |
| Test de santé embarqué | Tous les jours | Idéal la nuit ou en heure creuse |
Aspects pratiques et pièges à éviter
Quelques leçons que j'ai tirées en déploiement :
Ne pas s'en tenir uniquement aux valeurs RMS : surveiller les métriques de santé électrique et thermique.Documenter chaque recalage dans l'historique pour préserver la qualité des données — sinon les modèles d'IA deviendront inopérants.Veiller à la répétabilité mécanique : un capteur mal serré ou soumis à jeux mécaniques donnera des pseudo-dérives.Prévoir un capteur de référence et un plan de remplacement rapide : automatiser ne signifie pas éliminer la maintenance physique.Cas concret : retour d'expérience sur une ligne d'assemblage
Sur une ligne de production 24/7, nous avons équipé 120 points de mesure avec capteurs SKF et mis en place un shaker de référence sur chaque cartérisation critique. Après 6 mois :
les fausses alarmes ont chuté de 65 % grâce au recalage automatique,les interventions préventives inutiles ont diminué,la confiance des opérateurs dans les indicateurs a nettement augmenté.Le coût initial (shakers, edge compute) a été amorti en moins d'un an par la réduction des arrêts non planifiés et des diagnostics erronés.
Si vous souhaitez, je peux partager un schéma de mise en œuvre technique (architecture edge/cloud, API d'intégration avec SCADA ou GMAO) ou un modèle de routine de recalage que vous pouvez adapter à vos capteurs SKF et à votre plateforme IoT.