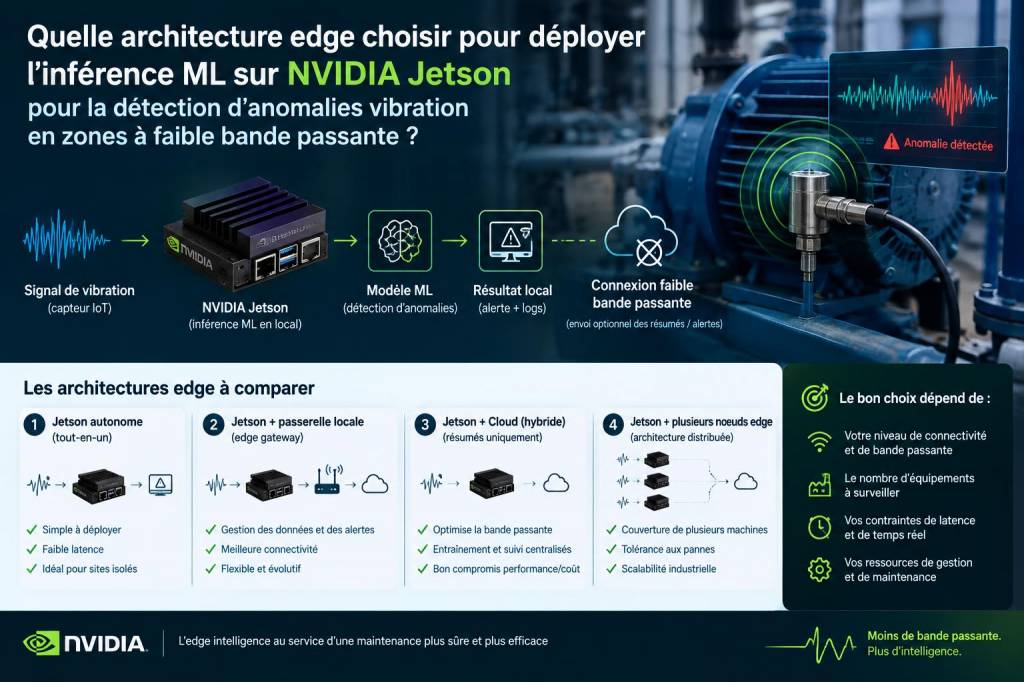
Lorsqu'on me parle de déployer de l'inférence ML pour la détection d'anomalies vibration sur des NVIDIA Jetson en zones à faible bande passante, j'ai tendance à revenir aux fondamentaux : quels sont les objectifs opérationnels, quelles contraintes réseau et énergétiques, et quel niveau de latence/robustesse attend-on sur place. Dans cet article je partage des architectures concrètes et les choix techniques que je privilégie, basés sur des projets industriels où la disponibilité réseau est limitée et où la maintenance prédictive doit rester fiable et évolutive.
Contexte opérationnel et contraintes
Avant tout déploiement, il faut clarifier :
Objectif : détection précoce d'anomalies vibration (roulements, déséquilibres, résonances) et déclenchement d'alertes exploitable par la GMAO/SCADA.Contrainte réseau : bande passante restreinte (ex. 50-200 kbps disponibles intermittents), latence élevée, coût des communications cellulaires.Environnement : sites éloignés, contraintes de puissance (alimentation solaire), températures ambiantes et poussières.Maintenance logicielle : possibilité de mises à jour OTA, mais préférer des mécanismes tolérants aux coupures.Ces éléments orientent fortement le choix d'architecture : plus on a de contraintes réseau, plus il faut pousser l'intelligence en local (edge), tout en conservant un plan pour l'orchestration et la supervision centralisée quand le réseau le permet.
Options d'architecture pertinentes
Je détaille ici trois architectures typiques adaptées au Jetson (Nano, Xavier NX, Orin Nano selon besoins) et à des scénarios de faible bande passante :
1) Edge-only (Inference 100% local)Description : le Jetson exécute la pipeline complète : acquisition vibrations (accéléromètre), prétraitement (filtrage, fenêtres FFT ou transformées temps-fréquence), extraction de features ou modèle end-to-end (CNN/1D-Conv/LSTM/Autoencoder), décision et stockage local court terme.
Avantages : tolérance parfaite à l'absence de réseau, latence minimale, protection des données sensibles.Inconvénients : nécessité d'un monitoring local robuste et d'un mécanisme d'export différé des logs/événements quand le réseau revient.2) Edge + Gateway (Hybrid local/edge)Description : le Jetson réalise l'inférence et conserve des résumés/événements. Un gateway (plus puissant ou simplement mieux connecté) reçoit périodiquement des packages compressés (features, spectrogrammes réduits, snapshots d'onde) pour corrélation centrale et mise à jour des modèles.
Avantages : bonne balance bande passante / visibilité centrale, possibilité d'agréger données de plusieurs Jetson avant envoi, simplification du monitoring central.Inconvénients : nécessite coordination entre nœuds et gateway, dépend d'une connexion intermittente mais moins fréquente et moins gourmande.3) Edge + Cloud (send-on-demand)Description : inference locale, mais données brutes ne sont envoyées au cloud que sur événements (anomalie détectée) ou windows programmés. Le cloud sert à entraîner périodiquement des modèles, analyser au long cours et orchestrer les mises à jour.
Avantages : optimisation du coût réseau, centralisation des analyses historiques, orchestration ML.Inconvénients : dépendance à la disponibilité réseau pour ré-entrainement et diagnostics approfondis.Composants logiciels et optimisation sur Jetson
Sur Jetson, l'efficacité de l'inférence est critique. Je recommande :
TensorRT pour optimiser les modèles PyTorch/TensorFlow : quantization INT8, pruning, et fusions d'opérations réduisent fortement l'empreinte mémoire et le temps d'inférence.DeepStream si on traite aussi des flux vidéos en corrélation avec vibrations ; sinon, des conteneurs Docker légers basés sur jetson-inference ou des images NVIDIA L4T.ONNX comme format d'échange : facilite la conversion et l'optimisation inter-framework.Edge containers : déployer l'application dans des conteneurs Docker (ou balena/Podman) facilite les mises à jour OTA partielles et l'isolation.Prétraitement local vs features à envoyer
Dans un contexte basse-bande, envoyer tout le bruit brut n'est pas envisageable. Voici un compromis efficace :
Faire sur le Jetson le prétraitement : filtrage band-pass, segmentation en fenêtres, calcul de spectrogrammes, MFCC/cepstral, enveloppe d'amplitude, features statistiques (RMS, kurtosis, skewness).Envoyer uniquement : résumés temporels (features), événements (anomaly-score + metadata), et, en cas d'alerte critique, un extrait brut court (quelques secondes) ou un spectrogramme compressé.Utiliser la compression et format binaire compact (protobuf, MessagePack) et protocoles basés sur MQTT (QoS adapté) ou CoAP pour minimiser overhead.Estimation de bande passante
| Item | Taille approximative | Fréquence |
|---|
| Feature vector (UTF-8 binaire) | ~1-5 KB | 1x/min ou 1x/10min |
| Event/alerte (score + snapshot) | ~2-20 KB | sur détection |
| Snippet 5s @ 16kHz 16-bit mono | ~160 KB (raw) → compressé ~40-80 KB | rare |
Avec ce modèle, une station peut fonctionner confortablement sous 100-200 kbps moyen, en gardant des marges pour pics d'envoi.
Mise à jour des modèles et gestion OTA
Les mises à jour doivent être incrémentales et résilientes :
Distribuer des modèles via un gestionnaire d'artefacts (ex. S3, Nexus, ou un serveur Git LFS) et utiliser un orchestrateur léger sur site qui vérifie l'intégrité (hash/signature) avant swap.Privilégier des mises à jour atomiques (swap de modèle plutôt que modification in-place) et rollback automatique si le modèle planté (watchdog).Si la bande passante est très limitée, ne distribuer que deltas ou quantized models (INT8) pour réduire la taille.Sécurité et fiabilité
La cybersécurité industrielle est une exigence. Mes recommandations :
Chiffrement en transit (TLS) et authentification mutuelle entre Jetson et gateway/cloud.Stockage chiffré des données sensibles sur le Jetson.Firewall local et règles strictes d'egress (limiter les destinations) pour réduire la surface d'attaque.Surveillance d'intégrité des fichiers et alertes locales si comportement anormal (CPU/GPU spike, écriture disque inhabituelle).Monitoring et observabilité
Même en réseau contraint, il faut conserver une visibilité :
Exporter des métriques légères via MQTT ou un agent Prometheus push : heartbeat, utilisation GPU/CPU, latence d'inférence, taux d'anomalies.Journaliser localement en circular buffer et pousser les logs compressés quand la connectivité revient.Pour l'analyse avancée, synchroniser périodiquement échantillons sélectionnés (ex. 1 % des données ou uniquement anomalies probables).Cas concret : mon schéma préféré
Pour des sites industriels isolés, j'ai souvent choisi l'architecture "Edge + Gateway" :
Jetson Xavier NX pour l'inférence, avec un MPU externe pour l'acquisition (ADXL355 ou PCB Piezotronics selon robustesse), prétraitement et feature extraction locaux.Gateway Raspberry Pi 4 / industrial gateway (4G/LoRaWAN selon disponibilité) agrège plusieurs Jetson et bufferise les uploads vers un back-end cloud (Azure IoT Hub ou AWS IoT).Modèles optimisés via TensorRT en INT8 sur le Jetson, envoi de features/minutes et snippets d'alerte compressés. Mises à jour orchestrées par un service cloud avec signatures numériques.Ce schéma offre une excellente tolérance au réseau, un bon niveau de centralisation pour l'analyse historique et une empreinte réseau maîtrisée.
Points d'attention pratiques
Planifier l'alimentation (UPS, protection contre surtensions) et la ventilation si Jetson est dans un boîtier clos.Valider le pipeline avec données réelles (tests en production temporaire) pour ajuster seuils et fréquence d'échantillonnage.Documenter clairement les procédures de rollback et de récupération physique — sur site, les interventions doivent rester simples.Si vous voulez, je peux vous fournir un schéma détaillé de déploiement, recommandations de configuration TensorRT, ou un exemple de pipeline MQTT/Protobuf pour minimiser la charge réseau. Dites-moi le type de Jetson envisagé (Nano, Xavier NX, Orin) et le profil de capteurs vibration et je prépare quelque chose d'opérationnel.